


Cosa sappiamo di Atlas, il modello di Ai creato da World Lab di Fei-Fei Li?
L’ambizione è costruire una rappresentazione coerente dello spazio, ricostruire ambienti tridimensionali e simularne l’evoluzione nel tempo.

3' di lettura
3' di lettura
Dopo aver insegnato alle macchine a riconoscere ciò che vedono, Fei-Fei Li vuole insegnare loro a immaginare che cosa troverebbero cambiando punto di vista. Atlas, il nuovo modello presentato da World Labs a inizio settembre, nasce con questa ambizione: costruire una rappresentazione coerente dello spazio, ricostruire ambienti tridimensionali e simularne l’evoluzione nel tempo.
Chiedilo al Sole
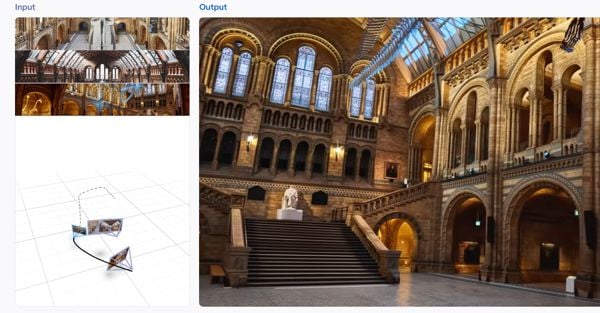
È un obiettivo diverso da quello dei chatbot. Un grande modello linguistico impara le relazioni statistiche tra le parole e genera la continuazione più probabile di un testo. Atlas tenta di fare qualcosa di analogo con lo spazio: combina testi, immagini, sequenze video, posizione delle telecamere e informazioni sulla profondità per prevedere che cosa dovrebbe apparire osservando una scena da un’altra angolazione.
Loading...
World Labs lo definisce un «omni world model» per l’intelligenza spaziale. Tecnicamente è un multimodal autoregressive diffusion transformer: un’architettura che riunisce elementi dei modelli linguistici e dei generatori di immagini. Tutti gli input vengono collocati in un contesto spaziale comune e il sistema produce progressivamente nuove viste, cercando di mantenere coerenti geometria, oggetti e prospettiva. World Labs
Chi è Fei-Fei Li
Il nome dietro World Labs spiega perché Atlas susciti tanta attenzione. Fei-Fei Li è docente di informatica a Stanford, cofondatrice dello Stanford Institute for Human-Centered Artificial Intelligence ed ex direttrice dello Stanford AI Lab. Tra il 2017 e il 2018 è stata inoltre vicepresidente di Google e chief scientist per AI e machine learning di Google Cloud. Stanford HAIIl suo contributo più noto è ImageNet, il grande archivio di immagini annotate che ha permesso di misurare e accelerare i progressi della visione artificiale. Fu proprio una competizione basata su ImageNet a rendere evidente nel 2012 il salto di qualità ottenuto dalle reti neurali profonde.
Cosa sa fare Atlas? Dalla fotografia a un ambiente tridimensionale
Come si legge nel sito Atlas può partire da una o più fotografie e generare ciò che una telecamera vedrebbe muovendosi intorno alla scena. La differenza rispetto a molti generatori video è che il percorso della telecamera non viene descritto soltanto a parole: posizione, direzione e movimento sono input nativi del modello. Secondo World Labs, questo permette di controllare con precisione inquadrature e traiettorie e di produrre filmati lunghi fino a un minuto, con risoluzione massima di 1440p.

Brand connect
Loading...

